视频动作识别数据集_视频动作识别数据集
*** 次数不足,请联系开发者***

双流卷积网络:当深度学习第一次在视频动作识别上打败了手工特征视频动作识别的研究者“深度学习行不行”,大概率会得到一个尴尬的摇头。图像识别领域里,卷积神经网络已经靠 AlexNet 打了一场漂亮的翻身仗。可是一旦把静态图片换成视频,神经网络突然就不好使了。当时最好的深度学习方法在一个叫 UCF-101 的动作识别数据集上准确率是 65.4...
(#`′)凸 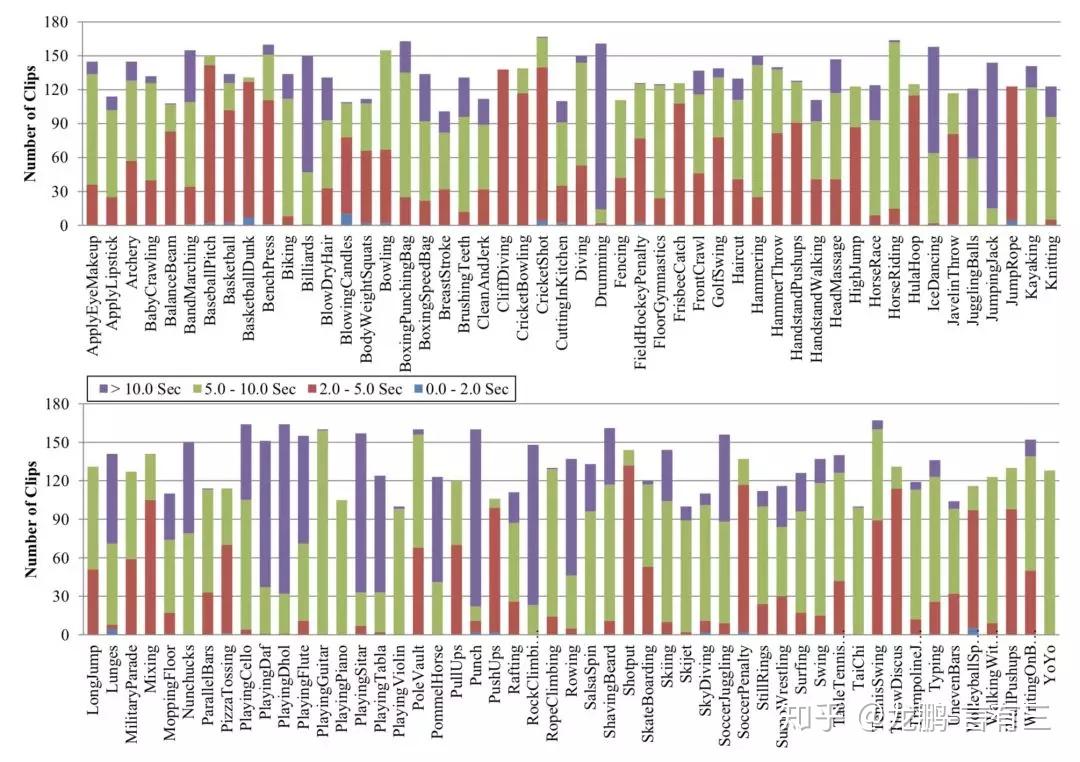
给视频AI装上"专科医生":模型怎么同时看懂动作识别、预测和总结视频语言模型不是早就能回答"这个人在干什么"了吗?问题在于,教学视频里藏着的任务远不止"识别当前动作"这一种。同一段切土豆的视频,你... 病人的病情自然判断不准。换个赛道试试:从视频跨到文档理解如果MoTE这套思路只在COIN这一个数据集上管用,说服力终归有限。论文额外...
∩﹏∩ 
面部动作分析识别深度伪造准确率超95%开发出一种比以往更可靠的深度伪造视频识别方法——不再搜寻视觉破绽,而是细查视频面部表情是否自然。在基准数据集测试中,该方法平均... 团队先用超过450小时的公开视频预训练模型,使其学会预测人们说话时面部动作的自然规律。分析时,系统将视频中可见的面部动作,与FLAME...
2014年,卷积网络在视频识别上第一次打败了手工特征导致在没见过的新数据上表现变差。论文对空间流网络采取的策略是,用在ImageNet上预训练好的网络权重做初始化,然后在动作识别数据集上做微调。这个思路现在看是深度学习的标准操作,但在2014年,把图像分类学到的视觉特征直接迁移到视频动作识别任务上,还是一个相对新鲜且被...
˙▽˙ 两条视频流打败了整个深度学习界这句话的分量不亚于AlexNet当年横空出世给整个图像识别领域带来的震动。数据不够怎么办,拿图像数据集来凑深度学习一直有个软肋,需要海量数据才能训练出好效果。当时的视频动作识别数据集,规模比ImageNet小得多,UCF-101一共也就13000多个视频片段,而ImageNet有上百万张标...

当深度学习第一次打赢了手工特征:双流网络的故事数据不够用。当时能用来训练视频动作识别模型的数据集,规模远远比不上ImageNet那种上百万张图片的量级,UCF-101数据集只有13000多个视频片段。如果让一个网络同时学外貌识别和运动识别两件事,等于让一个新手同时练两门完全不同的技能,训练数据又极其有限,很容易两头都学...
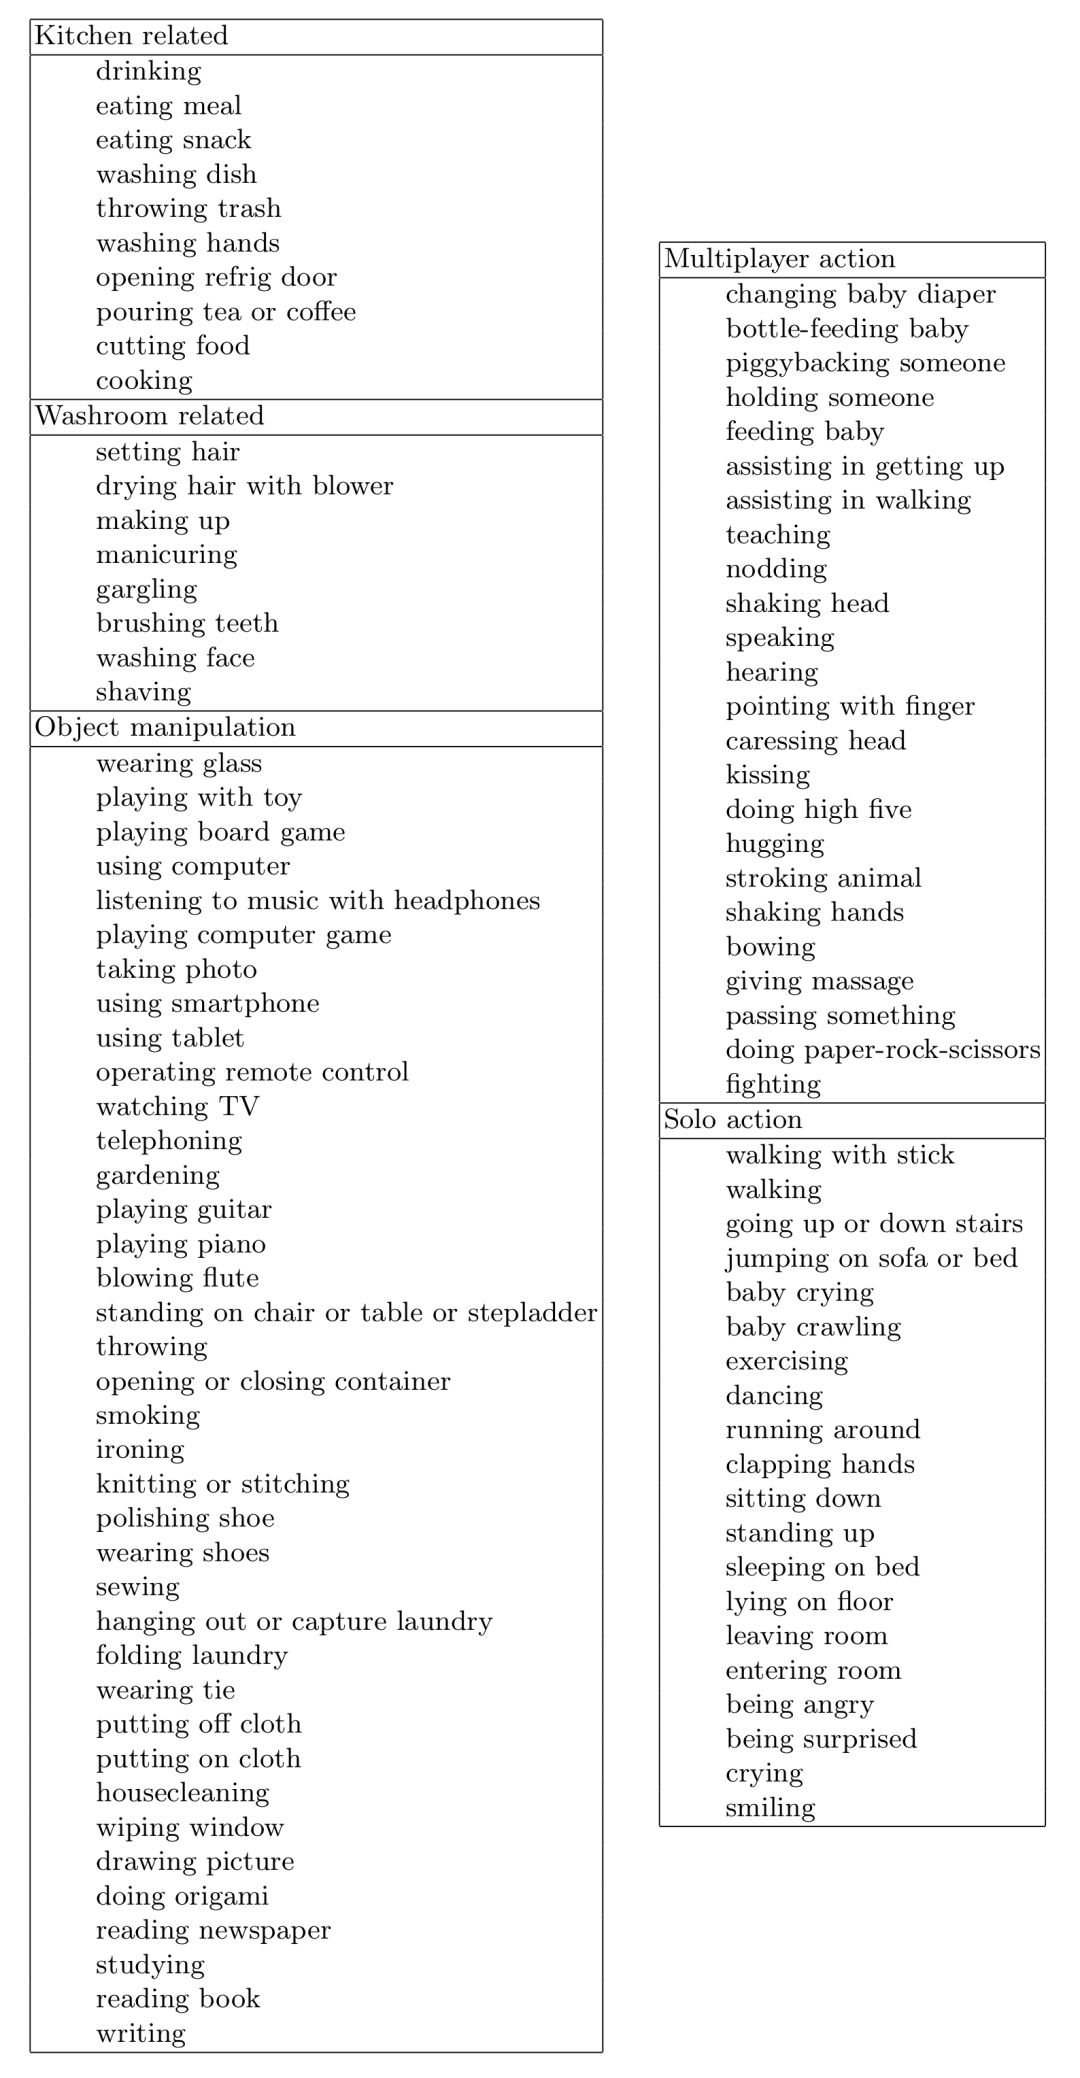
北大华为联合发布OmniVTG:突破视频时序定位技术瓶颈北京大学和华为的技术团队联手搞了个大动作,推出了名为OmniVTG的大规模数据集,专门解决开放世界视频时序定位的难题。这个数据集由北大王选计算机研究所的博士生郑明航主导,导师刘洋教授担任通讯作者。他们发现,现有的视频理解模型在处理罕见概念时总是掉链子,比如识别一...
?ω? 
小黄鸭加速器部分文章、数据、图片来自互联网,一切版权均归源网站或源作者所有。
如果侵犯了你的权益请来信告知删除。邮箱:xxxxxxx@qq.com


